La Generación Aumentada por Recuperación (RAG), que proporciona a los modelos de conocimiento externo, los flujos de trabajo basados en grafos, para orquestar tareas complejas, y los sistemas multiagente, que fomentan la colaboración y la especialización, son técnicas avanzadas que impulsan el desarrollo de agentes de IA.
RAG: potenciando a los agentes de IA con conocimiento externo
RAG es una técnica que conecta a un modelo de lenguaje grandes (LLM) con fuentes de conocimiento externas. Esto permite a los agentes de IA generar respuestas más precisas y contextualizadas.
¿Por qué es tan importante RAG?
A continuación, describimos tres razones claves para implementar RAG en soluciones de IA:
– Combate la «alucinación»: RAG utiliza información verificable de fuentes confiables. Esto reduce el riesgo de generar información errónea y asegura respuestas fundamentadas.
– Proporciona datos actualizados y específicos: A diferencia de los LLM tradicionales que operan con un conocimiento «congelado», RAG permite el acceso a datos en tiempo real, mejorando su utilidad en contextos empresariales específicos.
– Ofrece contexto y relevancia: Con RAG, los agentes de IA pueden responder a preguntas de dominios muy específicos, como la documentación interna o historiales médicos, gracias al contexto adicional que proporciona la base de conocimiento externa.
El pipeline de RAG
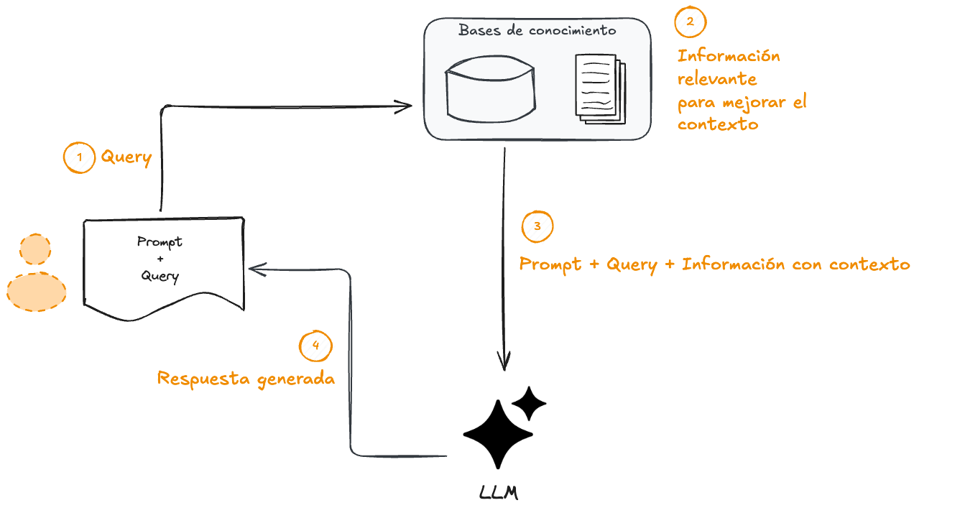
El proceso de RAG se estructura en varios pasos clave:
– Fragmentación (Chunking): Los documentos fuente (PDFs, webs, etc.), se dividen en fragmentos de texto más pequeños y manejables. Lo clave aquí, es elegir una estrategia y una ventana de superposición. Una buena segmentación, equilibra la preservación del contexto con la granularidad de la recuperación.
– Incrustación (Embedding): Cada fragmento se convierte en un vector numérico mediante un modelo de embedding. Este vector captura el significado semántico del texto, permitiendo realizar búsquedas de similitud.
– Almacenamiento e indexación (Upsert & Indexing): Los vectores se cargan en una base de datos vectorial (vector store), donde se indexan para permitir búsquedas de similitud ultrarrápidas.
– Consulta (Querying): Cuando un usuario realiza una pregunta, esta también se convierte en un vector. El sistema busca en la base de datos los vectores de fragmentos más similares semánticamente a la pregunta. Las consultas híbridas combinan la búsqueda de similitud vectorial con el filtrado tradicional de metadatos. Esto permite acotar los resultados en función tanto de la similitud semántica como de los campos de metadatos estructurados como fechas, categorías o atributos personalizados.
– Síntesis: Los fragmentos de texto recuperados se inyectan en el prompt junto con la pregunta original. El LLM utiliza este contexto enriquecido para generar una respuesta precisa y fundamentada.
Alternativas a RAG
Carga de contexto completo: Con la llegada de modelos avanzados con ventanas de contexto gigantescas, una alternativa es cargar todo el documento relevante directamente en el prompt. Es simple, pero puede ser costoso y el modelo podría «distraerse» con tanta información.
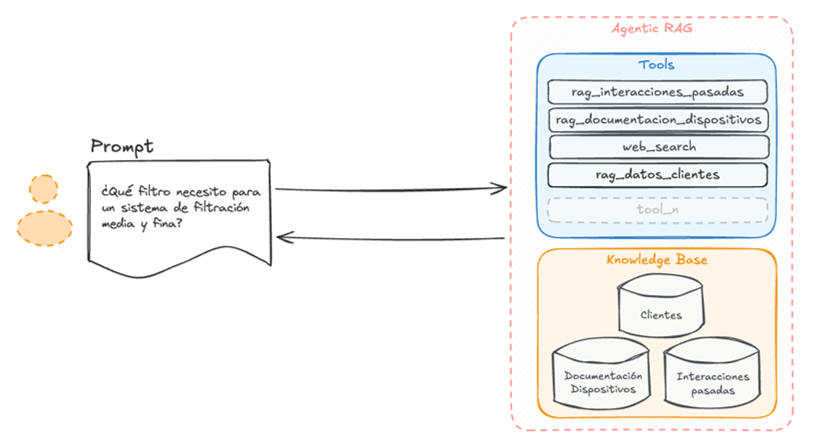
RAG Agente: En lugar de una simple búsqueda, un agente de IA utiliza un conjunto de herramientas para razonar sobre cómo y dónde buscar la información.
La ventaja del RAG agéntico es que puede ser más preciso que el RAG tradicional; en lugar de buscar texto relevante, el agente puede calcular respuestas exactas. La desventaja es que requiere construir y mantener las herramientas, y el agente necesita saber cómo usarlas eficazmente. Es más lento pero puede ofrecer resultados considerablemente más precisos.
Es preferible comenzar de forma sencilla, verificar la calidad y luego complejizar el proceso. Por ejemplo, el primer paso sería cargar todo el corpus en la ventana de contexto de Gemini. El segundo paso consiste en escribir funciones para acceder a su conjunto de datos, empaquetarlas en un servidor MCP y dejarlas disponibles para el agente.
Si en ninguno de los dos pasos se obtiene la calidad necesaria, entonces es recomendable considerar la construcción de un pipeline RAG.
A continuación se muestra un ejemplo sencillo de una solución RAG para un Servicio técnico de atención al cliente donde cada herramienta, al nutrirse de fuentes de datos específicas, optimiza la capacidad del Agente de IA para ofrecer respuestas precisas y relevantes, mejorando así la eficiencia y eficacia en la gestión de información.
Flujos de trabajo basados en grafos
A medida que las tareas se vuelven más complejas, se requiere una forma estructurada de gestionar cómo piensan y actúan los agentes. Los flujos de trabajo basados en grafos (Graph-based Workflows) proporcionan esta estructura, permitiendo un control más predecible sobre la ejecución del agente. Piénsalo como un diagrama de flujo para tu agente de IA.

Las operaciones clave en estos flujos de trabajo incluyen:
– Encadenamiento (Chaining): La ejecución secuencial clásica, donde la salida de un paso se convierte en la entrada del siguiente.
– Ramificación (Branching): Permite ejecutar múltiples operaciones en paralelo. Es activar múltiples llamadas a LLM con la misma entrada. Por ejemplo, si tiene un registro médico largo y necesita verificar la presencia de 12 síntomas diferentes (somnolencia, náuseas, etc.). Podría tener una llamada a un LLM que verifique los 12 síntomas. Pero eso es mucho pedir. Es preferible tener 12 llamadas a LLM paralelas, cada una verificando un síntoma.
– Fusión (Merging): Combina los resultados de diferentes ramas para consolidar la información.
– Condiciones: Permite tomar decisiones lógicas dentro del flujo, dirigiendo la ejecución por un camino u otro basándose en resultados intermedios.
Es útil componer los pasos de tal manera que la entrada/salida en cada uno sea significativa de alguna manera, ya que podrás visualizar el proceso. También es beneficioso descomponer los pasos, de modo que el LLM solo realice una tarea a la vez, lo que generalmente significa no más de una llamada a LLM en cualquier paso.
Una de las características más potentes es la capacidad de suspender y reanudar. Esto significa que un flujo de trabajo puede pausarse, guardar su estado y reanudarse más tarde, lo que resulta útil para procesos de larga duración o para implementar la intervención humana (human-in-the-loop), donde un humano necesita revisar y aprobar un paso antes de que el agente de IA continúe.
Sistemas multiagente
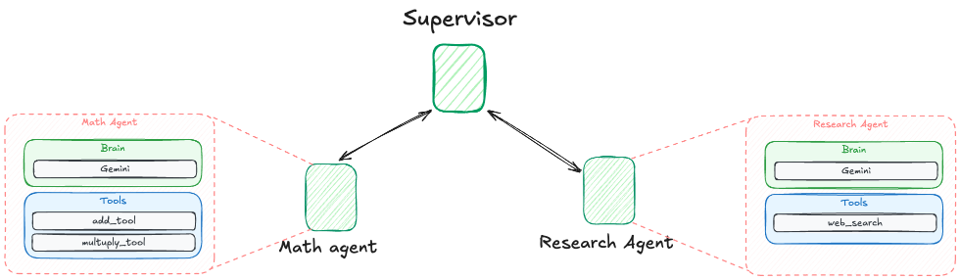
¿Por qué usar un solo agente cuando puedes tener un equipo de especialistas? Los sistemas multiagente implementan esta idea, coordinando a múltiples agentes de IA que trabajan juntos, cada uno con un rol y herramientas especializadas, para resolver un problema complejo.
Cada uno de estos agentes tiene diferentes memorias, diferentes prompts de sistema y acceso a diferentes herramientas. Imagina un equipo de marketing digital. Tienes un especialista en SEO, un redactor de contenido, un experto en redes sociales y un analista de datos. Un sistema multiagente funciona de manera similar:
– Un Agente Investigador podría usar herramientas de búsqueda web para recopilar información.
– Un Agente Escritor tomaría esa información para redactar un borrador.
– Un Agente Crítico revisaría el borrador en busca de errores y áreas de mejora.
Un ejemplo se puede consultar en este post, donde explicamos un asistente IA para generar propuestas y ofertas en pliegos de licitaciones públicas, para aumentar la tasa de éxito en las licitaciones y subvenciones públicas, reduciendo el tiempo de preparación de ofertas y garantizando el cumplimiento normativo en licitaciones.
El Supervisor de Agentes
Un componente clave en estas arquitecturas es el Supervisor de Agentes, a veces llamado también Orquestador. Este es un agente de IA «director de orquesta» cuyo trabajo es descomponer la tarea principal, asignarla al agente correcto y coordinar la comunicación entre ellos. A menudo, el supervisor trata a los otros agentes como si fueran herramientas.
Los estándares de comunicación MCP (Model Context Protocol) y A2A (Agent-to-Agent) son protocolos diseñados para estandarizar la forma en que los agentes de IA se conectan y colaboran entre sí y con herramientas externas.
Estándares de Comunicación
Los estándares de comunicación MCP (Model Context Protocol) y A2A (Agent-to-Agent), son protocolos diseñados para estandarizar la forma en que los agentes de IA se conectan y colaboran entre sí y con herramientas externas.
Model Context Protocol (MCP)
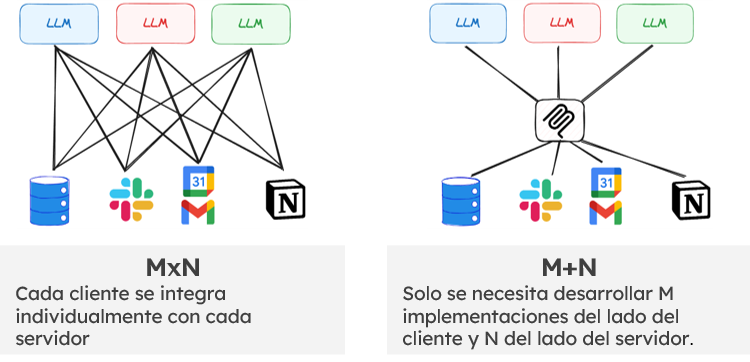
Model Context Protocol (MCP) es un protocolo abierto que estandariza cómo las aplicaciones proporcionan herramientas a los Modelos de Lenguaje Grande (LLMs) y cómo los agentes de IA se conectan entre sí. Su objetivo es resolver el problema de integración «N x N» (donde cada proveedor de IA y cada autor de herramientas tenían su propia forma de definir y llamar herramientas), actuando como un «puerto USB-C para aplicaciones de IA» . Esto permite que una herramienta o agente compatible con MCP se conecte a cualquier otro sistema compatible, independientemente de quién lo haya construido o en qué lenguaje está escrito.
MCP se basa en dos funciones principales:
– Servidores: Estos envuelven un conjunto de herramientas MCP y pueden estar escritos en cualquier lenguaje. Se comunican con los clientes a través de HTTP.
– Clientes: Modelos o agentes que pueden consultar a los servidores para obtener la lista de herramientas disponibles y luego solicitar la ejecución de una herramienta específica y recibir una respuesta.
Si tu hoja de ruta incluye muchas integraciones de terceros (como calendario, chat, correo electrónico, web), podría ser útil construir un cliente MCP. Por el contrario, si estás desarrollando una herramienta que deseas que otros agentes de IA utilicen, deberías considerar crear un servidor MCP.
Agent-to-Agent (A2A)
Agent-to-Agent (A2A) es un protocolo desarrollado por Google que facilita la comunicación entre «agentes no confiables». Al igual que MCP, A2A busca resolver el problema de integración «N x N» que surge cuando diferentes agentes de IA utilizan distintos frameworks y necesitan interactuar.
Funcionamiento:
– Se basa en un archivo de metadatos JSON (/.well-known/agent.json) que describe las capacidades del agente, su URL de endpoint y los requisitos de autenticación.
– Una vez autorizados, los agentes pueden enviarse tareas entre sí utilizando un sistema de colas.
– Las tareas tienen IDs únicos y progresan a través de varios estados (enviada, en progreso, requiere entrada, completada, fallida, cancelada).
– Soporta patrones síncronos de solicitud-respuesta y streaming para tareas de larga duración mediante Server-Sent Events.
– La comunicación se realiza a través de HTTP y JSON-RPC 2.0, con mensajes que pueden contener texto, archivos o datos estructurados. Los agentes pueden generar artefactos como salidas y enviar actualizaciones en tiempo real.
– Utiliza autenticación web estándar (OAuth, claves API, códigos HTTP).
A2A es más reciente que MCP. Aunque Microsoft lo soporta, ni OpenAI ni Anthropic lo han adoptado, posiblemente porque consideran a MCP como una solución competitiva. Se espera que uno o varios protocolos de interoperabilidad de agentes de los grandes actores se conviertan en el estándar predeterminado en el futuro.
Mientras que MCP se enfoca en estandarizar cómo los agentes acceden y utilizan herramientas, A2A se centra en la comunicación y el intercambio de tareas directamente entre agentes, especialmente en escenarios donde los agentes pueden provenir de diferentes sistemas o ser «no confiables».
¿Quieres aprovechar las capacidades de la Inteligencia Artificial en tu empresa? Pónte en contacto con nosotros en consulta@komorebi.ai.